指南2026-08-15 · 5 分钟读完
同一个角色为什么每个镜头长得不一样
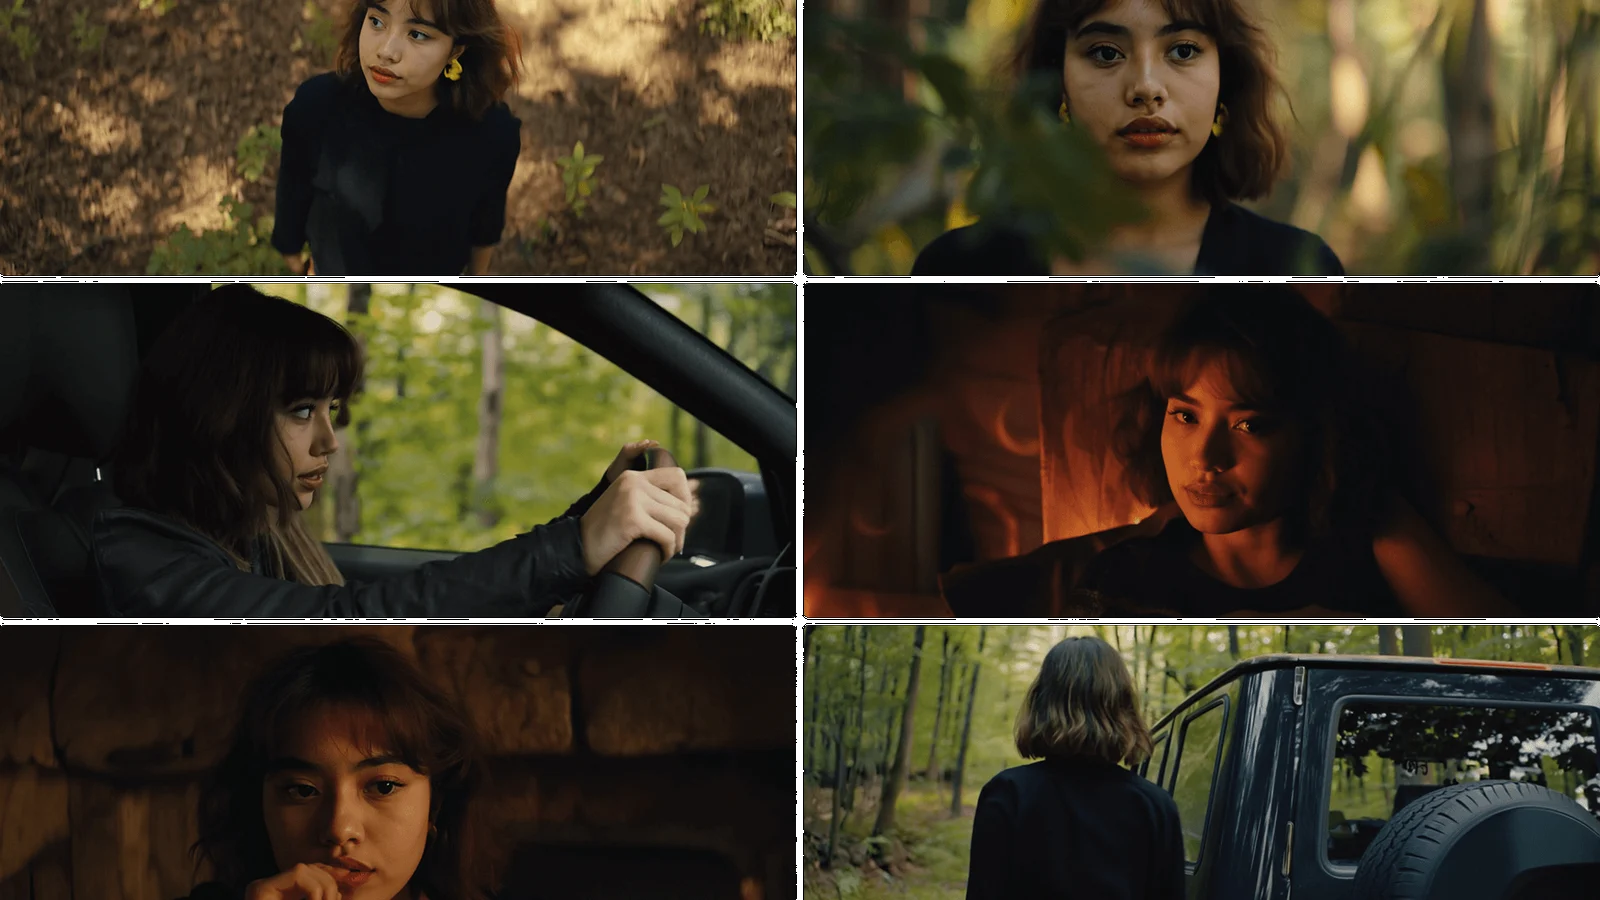
让视频模型生成「三十多岁的女人站在酒店走廊」两次,你会拿到两个不同的女人。这不是谁会去修的bug。模型在两次调用之间并不记得这个人,每次生成都是重新画一遍,而能精确到一张脸的文字描述根本不存在
解决办法不是写得更细。是给一张图
一张图才是解法
当一个镜头是从这个角色的真实图像出发生成的,而不是从描述她的文字出发,模型手里就有这张脸,不用去猜。我们选择器里的每个视频模型都吃参考图,最强的一个一次吃五十张
所以这里的角色库是独立存在的,不属于某一集。你把一个角色定下来一次,之后每一集的每一个镜头都从同一张参考图生成。角色不再是一句话,而是一个文件
场景也会漂
场景是同一个道理。用文字描述两次的酒店走廊是两家酒店,用一张图生成的酒店走廊,在第3个镜头和第14个镜头里是同一条走廊。像锁角色一样把场景锁住,观众就不会再看到接缝
实话实说的边界
这做不到完美,也不该说成完美。光会变,角度会飘,远景里一张脸就是几个像素的事。但「从参考图生成」和「从描述生成」的差别,就是一部剧和一堆陌生人幻灯片的差别
还有问题吗
锁角色需要我自己的照片吗
不需要。你可以先把角色生成一次,挑一张满意的,那张生成图就成为之后所有镜头的参考
哪些模型锁脸最稳
吃参考图最多的那些。Seedance 2.5 一个镜头最多50张,其他大多在1到9张。每个模型页都写了自己的数字
参考图要另外收费吗
几乎所有模型都不收。有一个模型每张参考图收一美分,这个价格和其他所有费用一样,都会显示在按钮上